
分类模型说事件有九成概率,怎样用可靠性图检查这九成是否兑现
可靠性图应比较二分类正类概率的桶内平均值与桶内真实正类比例。它回答“预测九成的这类记录,正类是否约占九成”,不是把预测是否正确当成纵轴,也不是把聊天模型的自信措辞当作概率。
保持正类定义不变
附件p_positive始终表示同一个正类事件的概率,y只取0或1。即使某条概率为0.1、最终分类标签为负类,也仍把0.1放在横轴,y放在纵轴计算中。不能取max(p,1−p)之后又继续使用正类比例,这会混合两种不同问题。输入六条均为手工合成,没有展示某个模型已经校准或已经失准的实测结论。
固定分桶边界再汇总
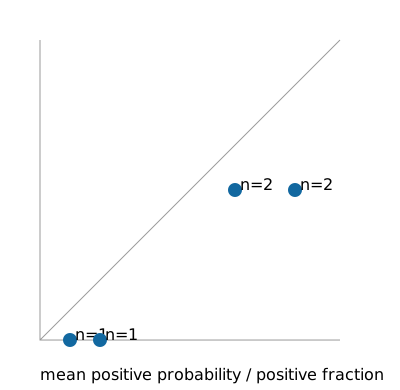
样例把[0,1]划为五个等宽桶,左闭右开,最后一桶包含1。每桶保存数量n、平均正类概率和正类比例。0.6与0.7所在桶的平均概率为0.65,实际正类比例为0.5;0.8与0.9所在桶平均概率0.85,正类比例仍为0.5。图上的点应连同n一起读,小桶一个样本变化就可能造成很大摆动。
空桶没有观察比例
0.4至0.6之间没有记录,因此表中保留空桶且均值为空,不补成坐标原点。reliability.svg中的对角线只是理想对应关系的参照,不是用六条数据拟合出的承诺。实际比较两个模型时,应尽量使用同一测试分布与明确的分桶规则;改变桶宽就改变了图的平滑程度,不能挑一张最顺眼的图作为充分证据。
图之外还要检查数据来源
失败命令把一个概率设成1.2,程序明确拒绝。NaN、无穷值、非二值标签也不应悄悄进入分桶。若概率来自训练集或挑选后的成功案例,图不能代表未见数据;分布漂移后旧图同样可能失效。校准处理需在适当数据上拟合,再用独立数据评估,不能把测试标签用于调整后又在原表宣称改善。该附件帮助读者检查统计口径,并不提供模型概率质量的外推保证。
将分桶表与图同时保留,能防止某个点看起来贴近对角线却只有一条记录。复查某桶时可按原id回到样本,看标签是否延迟产生、是否混入另一个正类定义;概率字段名称相同并不能保证数据来源使用同一事件口径。
下载与复现
下载完整样例包,解压到一个新文件夹;也可查看全部文件清单和主脚本。使用Python 3.10或更新版本,在解压目录运行。此脚本只使用标准库,无需安装额外包。
python -B run.py
python -B run.py --negative
先查看主要结果,再修改输入重跑;已有输入会保留,结果写回同目录。边界命令可能故意非零退出,也可能输出明确的不适用状态,按正文说明判断,不把所有非零退出都当成安装故障。
依据与延伸阅读
资料核对日期为2026年10月24日。一手资料1:二分类可靠性图对照桶内平均正类概率与实际正类比例,空桶没有观察比例。
继续阅读:模型分类准确率有 90%,为什么少数类别仍然可能一条都没分对;让分类模型低把握时交给人工,怎样选择覆盖率与错误率的折中点;检索都找到了相关段落,怎样比较重要段落是否排在前面。
留言讨论
评论发布后会被人工复核,违规内容将被删除。
如果发表没有反应,可以前往联系我们告诉我们。